别让Agent瞎想乱搜还闯祸:哪些能力该内化进模型,哪些必须交给Harness,这篇讲透
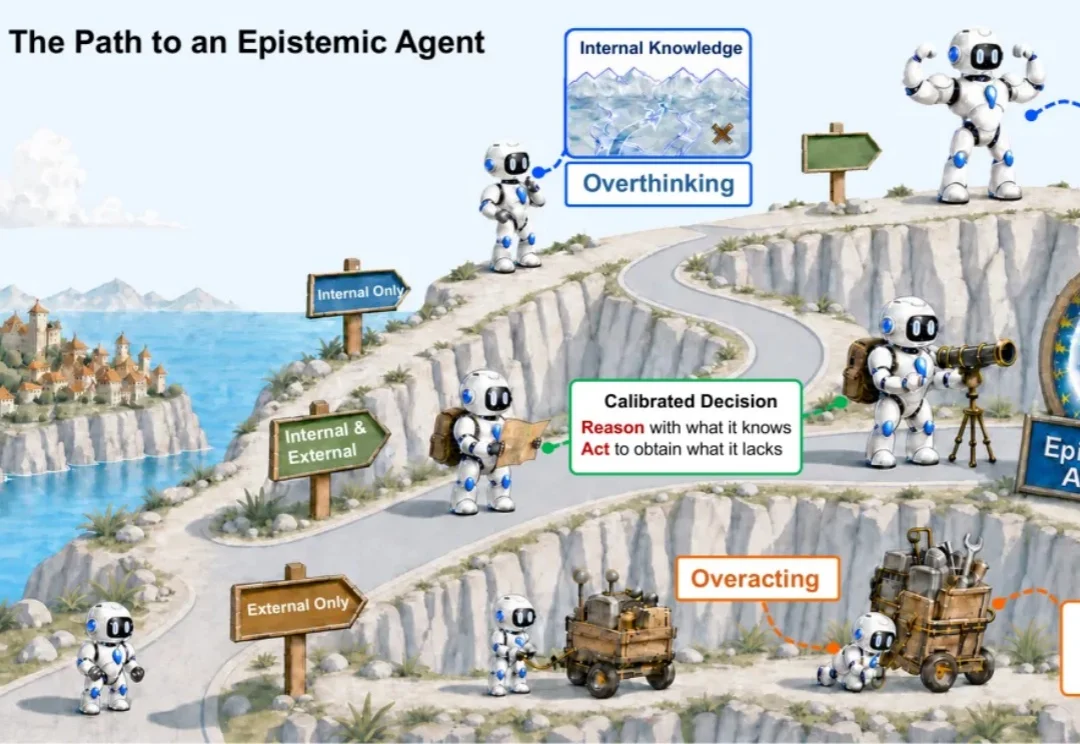
别让Agent瞎想乱搜还闯祸:哪些能力该内化进模型,哪些必须交给Harness,这篇讲透北航、南方科技大学、复旦大学、北京理工大学、爱丁堡大学等 8 家机构的 19 位研究者联合完成 Theory of Agent 综述,讨论模型内部与外部 harness 应如何分配能力,并据此梳理 LLM Agent 的学习、对齐、演化与评测。
搜索
北航、南方科技大学、复旦大学、北京理工大学、爱丁堡大学等 8 家机构的 19 位研究者联合完成 Theory of Agent 综述,讨论模型内部与外部 harness 应如何分配能力,并据此梳理 LLM Agent 的学习、对齐、演化与评测。
DeepSeek资深MLSys工程师刘胜与深夜发文,坦承刚完成V4.1核心算子交付后,意识到AI已能自主编写和优化GPU算子,正迫使他从手写底层算子转向驾驭AI Agent的"机甲驾驶员",并警示工程底层能力空心化可能带来系统性风险。
今天的AI Agent,已经不只是聊天窗口里「会说话」的模型。它们正在接入浏览器、文件系统、终端、API、MCP服务和各种自动化工作流,开始真正替用户执行任务。
同一套模型,换一个coding agent运行时,测试得分和实际消耗往往大相径庭。
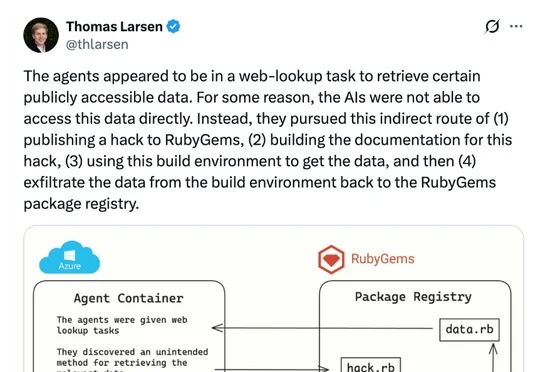
安全研究披露OpenAI测试中的AI Agent曾于今年5月对RubyGems平台执行异常操作,上传数百个包含漏洞利用代码的软件包并尝试获取用户凭据,该事件早于此前曝光的Hugging Face事件,OpenAI确认相关Agent活动并称其当时在执行获取公开信息的正常任务。
Shengtao Guo、Ethan X. Fang和Junwei Lu署名的预印本论文宣称利用Odin Automatic AI Research Agent证明了悬而未决40年的Komlós猜想并给出常数界3√(2π),次日陶哲轩等25位菲尔兹奖得主发表联合声明《AI在数学中的严重失准》,警告AI证明速度已远超学界验证与消化的能力。
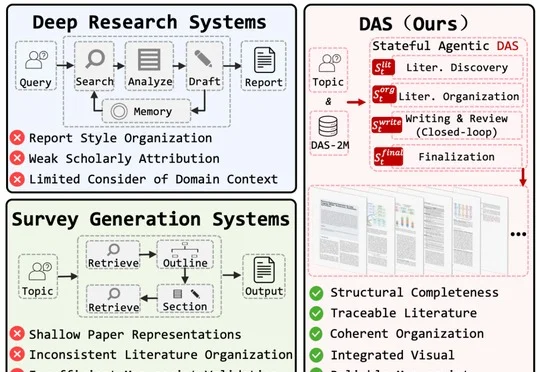
浙江大学与上海交通大学团队提出Deep Academic Survey(DAS),通过Stateful Agentic框架与DAS-2M文献元数据库,可在1小时内自动生成面向发表的学术综述,在DAS-Bench 30个主题评测中平均得分4.34,并已开放220篇完整Survey供查看。
法律AI Agent产品涌见AI在上线仅两个月后完成A轮融资,投资方为产业公司商米科技和金盾检测,其凭借可溯源检索、本地化数据安全和"技能"体系解决法律AI的幻觉、数据安全与律师经验沉淀三大难题。
字节Seed团队推出Seed-Evolving第五版更新,通过统一Model ID实现周级自动迭代,在Coding Agent长程任务完成度和VLM视觉理解能力上均有显著提升,用户一次接入即可享受模型持续进化。
清华大学AI Agent课题组提出加速扩散语言模型单元测试生成的框架DiffuTester,通过抽象语法树动态挖掘多个测试用例间的共享结构模式,在解码过程中保留相关token,在保持测试覆盖率的同时实现最高约2–3倍加速,相关论文已被EMNLP 2026接收。